이 문서는 이전 Windows 환경의 이력이다. 현재 WSL의 실제 Meep·CUDA 실행과 후속 수정은 WSL 실측 비교를 참고한다.
GPU 실행 및 솔버 수치 검토 (2026-11-02)
이전의 “GPU 지원 솔버 6개”는 라이브러리의 잠재적 지원 개수였다. 현재 COMPASS 어댑터가 실제 GPU에서 올바르게 계산한다는 검증 결과가 아니다. 이번 환경에서 확인된 GPU 실행은 0개다. GPU 성능 순위나 CPU 대비 가속률은 측정하지 못했다.
실행 환경과 재현
- NVIDIA GeForce RTX 4060 Ti, VRAM 16 GB, NVIDIA 드라이버 610.88.
- 프로젝트
.venv: PyTorch2.11.0+cpu,torch.version.cuda=None,torch.cuda.is_available()=False. - JAX
0.10.0:CpuDevice(id=0)만 존재. fdtdz,fdtdx, MIT Meep 미설치. Meep 실행 결과가 저장소에 있는지도 검색했으나 실제 Meep 수치 데이터는 찾지 못했다.- CUDA PyTorch 설치를 위한 인덱스 연결은 네트워크 터널 연결 거부로 실패했다. WSL 배포판 조회는
E_ACCESSDENIED, Docker Linux 엔진은 실행되지 않은 상태였다. 기존 환경의 패키지는 변경하지 않았다. - 재현:
.venv/Scripts/python.exe scripts/audit_solver_execution.py. - 원시 결과: metrics.json. 그림·종합 지표·추가 수렴 자료는 공개 경로에 보존했다. 개별 요청 JSON과 오류 로그는 로컬
outputs/gpu_solver_audit/에 있다.
실제 장치와 실행 가능 여부
솔버/백엔드별 CPU와 CUDA 요청을 각각 독립 프로세스에서 실행했다. 메타데이터의 장치 이름 외에 PyTorch 고유값 계산 입력 장치, meent 인스턴스 장치, JAX 배열 장치, FDTD 필드 장치도 관찰했다. 총 20개 조합이다.
| 솔버 | CUDA 요청 시 이번 실행 | 코드 검토 |
|---|---|---|
| torcwa | CUDA 빌드가 없어 실패 | 라이브러리 생성과 유전율 텐서에 요청 장치를 전달한다. CUDA 환경에서 재검증 필요 |
| grcwa | 성공하지만 CPU 계산 | 어댑터가 요청 장치를 계산에 사용하지 않는다. NumPy/autograd 기반 |
| meent/numpy | 성공하지만 CPU 계산 | CUDA 요청이 NumPy 백엔드를 GPU로 바꾸지 않는다 |
| meent/torch | 실패; 생성된 인스턴스는 CPU | call_mee에 장치를 전달하지 않는다. np.sum(torch.Tensor)에서 인자 호환 오류도 발생 |
| meent/jax | optax 미설치로 실패 | 요청 장치 선택 및 실제 장치 검증이 없다 |
| fmmax | 성공하지만 JAX 배열은 cpu:0 | CPU 요청만 명시적으로 설정하고 CUDA 요청 시 GPU를 강제하지 않는다. 앞선 CPU 설정의 전역 상태에도 영향을 받을 수 있음 |
| fdtd_flaport | CUDA 백엔드 불가로 실패 | CUDA 백엔드 선택은 구현. 그러나 흡수 damping 텐서가 CPU에서 생성되어 CUDA 필드와의 연산에 장치 불일치 위험. 정상상태 구간의 매 스텝마다 전체 E/H를 CPU로 복사하는 성능 병목도 있음 |
| fdtdz | 미설치로 실패 | 현재 fz.simulate(...) 호출은 upstream의 fdtdz() API와 불일치. 손실 유전율과 PML 프로파일을 계산하지만 실제 호출에 사용하지 않음 |
| fdtdx | 미설치로 실패 | fx.simulate(...) 호출을 현재 upstream의 설정/객체 배치/실행 API에 맞춰 검증해야 함. 손실 유전율과 PML 프로파일이 사용되지 않음. 멀티 GPU 분할을 수행하는 코드도 확인되지 않음 |
| Meep | 미설치로 실패 | CPU 기준 솔버 후보이나 아래의 수치 구현 문제 해결과 실제 실행 검증 필요 |
fdtdz와 fdtdx의 실행 가능성은 이번에 라이브러리를 설치해 검증하지 못했다. 코드/API 불일치는 검토 결과이며 실제 설치 버전에 대한 런타임 실패를 측정한 것으로 해석하면 안 된다. fdtdz upstream, FDTDX API.
비교 조건과 해석 범위
해석해가 있는 공기/유리/공기 박막을 사용했다. 유리는 두께 0.1 µm, 굴절률 1.5, 소광계수 k=0 및 0.05. 파장은 450/550/650 nm, 수직 입사 TE다. RCWA는 축별 차수 [1,1], grcwa는 nG=10, 복소수 배정밀도를 사용했다. JAX의 x64를 활성화했다. FDTD는 양쪽에 공기 0.4 µm, 격자 25 nm, PML 12셀, 시간 20 fs를 사용했다.
각 재료 조건에서 첫 실행 1회와 반복 실행 3회를 측정했고, 반복 중앙값을 표에 사용한다. 시간은 run()만 포함하며 필요한 동기화와 결과의 NumPy 변환이 끝난 시점까지 측정했다. Python 프로세스 시작 및 geometry/source 설정 시간은 제외된다. run() 내부의 지연 import는 첫 실행에 포함될 수 있다. PyTorch 스레드는 1개다. JAX/XLA의 모든 스레드를 1개로 제한한 측정은 아니다.
이 작은 박막의 CPU 시간으로 큰 픽셀, GPU 속도, 메모리 사용량, 솔버 전반의 성능 순위를 추정할 수 없다. TMM은 박막의 R/T/A 기준이다. 흡수 A를 1-R-T로 정의하는 구현에서는 합이 1이라는 사실만으로 정확성이 입증되지 않는다.
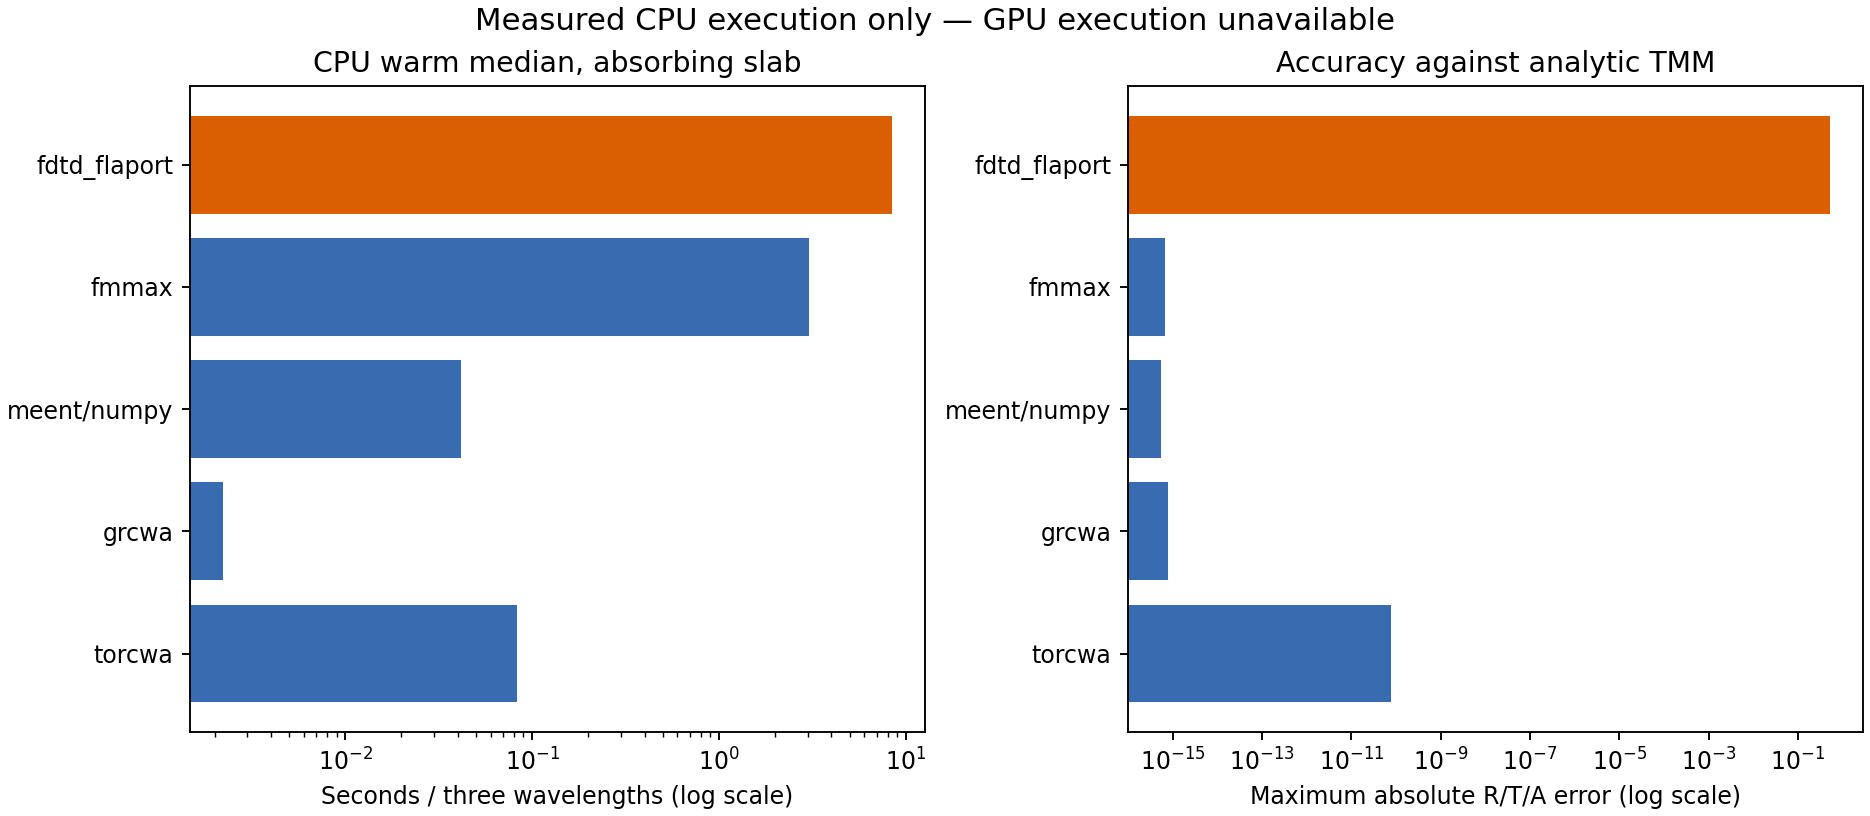
CPU 성능과 해석해 대비 오차
| 솔버 | k=0 시간 (초) | k=0.05 시간 (초) | 6개 조건의 최대 R/T/A 절대 오차 |
|---|---|---|---|
| torcwa | 0.013713 | 0.082878 | 7.847e-11 |
| grcwa | 0.002069 | 0.002230 | 7.772e-16 |
| meent/numpy | 0.040944 | 0.041787 | 5.551e-16 |
| fmmax | 2.938976 | 3.030188 | 6.661e-16 |
| fdtd_flaport | 7.869230 | 8.387168 | 5.127e-01 |
각 시간은 3개 파장을 모두 계산한 실행 1회의 반복 중앙값이다. 모든 값은 CPU 실측이며 GPU 벤치마크가 아니다.
550 nm, k=0.05의 실제 값
| 솔버 | R | T | A |
|---|---|---|---|
| TMM 해석해 | 0.132837603 | 0.771208136 | 0.095954261 |
| torcwa | 0.132837603 | 0.771208136 | 0.095954261 |
| grcwa | 0.132837603 | 0.771208136 | 0.095954261 |
| meent/numpy | 0.132837603 | 0.771208136 | 0.095954261 |
| fmmax | 0.132837603 | 0.771208136 | 0.095954261 |
| fdtd_flaport | 0.000000000 | 0.443383386 | 0.556616614 |
| Meep | 미측정 | 미측정 | 미측정 |
무손실 550 nm의 해석해는 R=0.145368448, T=0.854631552, A=0이다. flaport는 기본 25 nm / 20 fs에서 R=0, T=0.487281396, A=0.512718604를 반환했다. 출력이 유한하더라도 물리적으로 타당한 결과는 아니다.
flaport 추가 격자·시간 확인 (무손실, 550 nm)
| 격자 (nm) | 시뮬레이션 시간 (fs) | R | T | A |
|---|---|---|---|---|
| 25 | 20 | 0 | 0.487281396 | 0.512718604 |
| 25 | 60 | 0.000000000 | 0.507316700 | 0.492683300 |
| 12.5 | 20 | 0.000000000 | 0.475135597 | 0.524864403 |
| 12.5 | 60 | 0.000000000 | 0.476146911 | 0.523853089 |
격자를 절반으로 줄이고 시간을 3배로 늘려도 무손실 흡수가 약 0.52로 남는다. 이 범위에서는 단순히 시간을 늘리는 것으로 정확성이 회복되지 않았다. 이 추가 확인은 각 조건 1회 실행이며 성능 중앙값 표에는 포함하지 않았다. 원시 자료: flaport_convergence.json.
Meep 결과를 기준값으로 쓰기 전에 필요한 수정
Meep 수치와 시간은 미측정이다. 다른 FDTD 스크립트의 자체 구현 결과를 Meep 결과로 대체하지 않았다. 현재 공개 Meep은 CUDA/OpenCL GPU를 지원하지 않으므로 CPU 기준 솔버로 비교해야 한다. Meep 공식 FAQ.
- 소스/측정면이 PML 안에 있음. 셀 길이가
total_z + 2*pml_thickness이므로 위쪽 PML은 구조 최상단total_z/2부터 시작한다. 소스는 그보다0.3*pml_thickness, 반사 측정면은0.1*pml_thickness위에 있다. 투과 측정면도 아래쪽 PML 내부다. PML 밖의 균일한 공기 영역에 소스/측정면을 두도록 별도 padding을 확보해야 한다. - QE 필드를 읽기 전에 초기화.
_run_single_wavelength()가sim.reset_meep()후 반환하고, 호출자는 그 뒤_compute_pixel_qe()에서sim.get_dft_array()를 호출한다. 필드를 읽은 뒤 초기화하도록 순서를 수정하고 실제 API에서 검증해야 한다. - QE가 입사광 기준이 아님. 현재 반환값은
pixel_abs / total_absorbed다. 입사 파워와 흡수 파워의 비율인 QE와는 의미가 다르다. 다른 솔버들의 QE와 직접 비교할 수 없다. - 약한 흡수가 누락됨.
k <= 0.01또는use_dispersive=False이면 허수 유전율을 버린다. 또한 실수 유전율을 최소 1로 제한하여 금속 등의 물성이 달라진다. - 실행시간 상한이 아님.
runtime_periods는 decay 체크 간격 계산에 사용된다.until_after_sources=stop_when_fields_decayed(...)에 별도의 강제 종료시간은 없어 이름만으로 최대 실행시간을 보장하지 않는다.
관련 구현: compass/solvers/fdtd/meep_solver.py의 run, _run_single_wavelength, _get_meep_material, _compute_pixel_qe.
기존 픽셀 QE 자료의 검토
기존 RCWA parity 원시 자료는 전부 CPU 실행이다. 이번 박막 실행 결과와 별도 데이터다. 550 nm의 픽셀 평균 QE는 torcwa 0.005738, grcwa 0.895839, meent/numpy 0.905928, fmmax 0.897300으로 큰 차이가 있다. torcwa는 field_integration, 나머지는 eps_imag_weight 방식이다. R/T/A가 비슷하더라도 이 QE들을 같은 물리량의 동등한 구현으로 취급하면 안 된다. 패턴 형상/차수 수렴과 입사 파워 기준 QE 정의를 통일한 뒤 Meep과 다시 비교해야 한다.
후속 작업 우선순위
- CUDA 지원 PyTorch와 Linux/WSL GPU JAX, MIT Meep을 실행할 수 있는 환경 확보. GPU 없는 경우 CUDA 요청을 조용히 CPU로 실행하지 않고 실패시키는 검증 추가.
- meent 장치 전달 및 결과의 backend별 합산/CPU 변환 수정. flaport의 CUDA damping 장치와 CPU 복사 병목, 플럭스 측정 정확성 수정.
- Meep 소스/플럭스 영역, 필드 수명, 재료 손실, 입사 파워 기준 QE 수정. fdtdz/fdtdx를 실제 upstream API에 맞춰 구현.
- 같은 박막에서 무손실/흡수/격자 수렴을 통과한 다음, 동일한 패턴 픽셀에서 차수·격자·시간 수렴 및 GPU cold/warm 시간과 메모리 측정.
검토를 위해 측정 스크립트와 보고서를 추가했으며, 솔버 구현 자체는 수정하지 않았다. JAX의 네이티브 Windows CUDA 미지원 및 WSL 경로는 공식 설치 문서를 참고한다.