Meep 기준 CPU/GPU 솔버 비교
Meep 기준값: 수렴 미확정. 450/550/650 nm 실측 R/T/A와 CPU/GPU 속도를 비교한다. 기준값이 승인되기 전까지 정확도 비교는 잠정 결과다.
차트로 비교하기
그림을 누르면 SVG 원본으로 확대할 수 있다.
1. Meep 수렴 상태
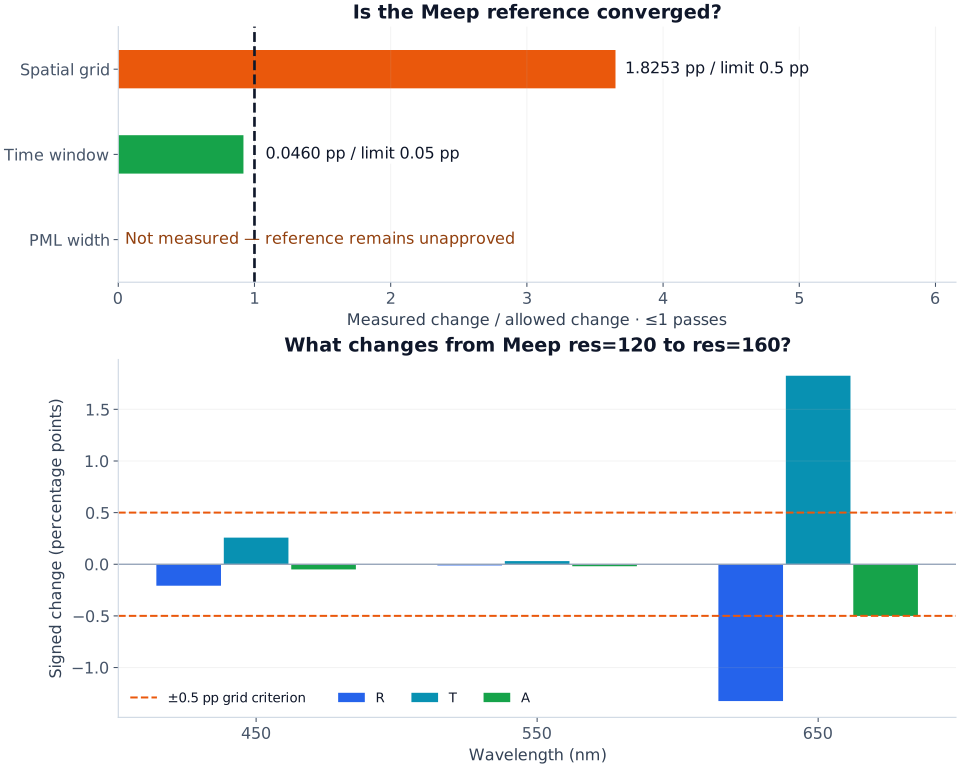
점선 1 이하면 해당 변화 기준을 통과한다. 시간은 통과했지만 공간 격자는 기준을 넘었고 PML은 미측정이다. 아래쪽 막대는 해상도 120→160에서 R/T/A가 얼마나 움직였는지 보여준다. 이 격자 변화는 참값에 대한 오차 상계가 아니다.
2. 파장별 반사·투과·흡수
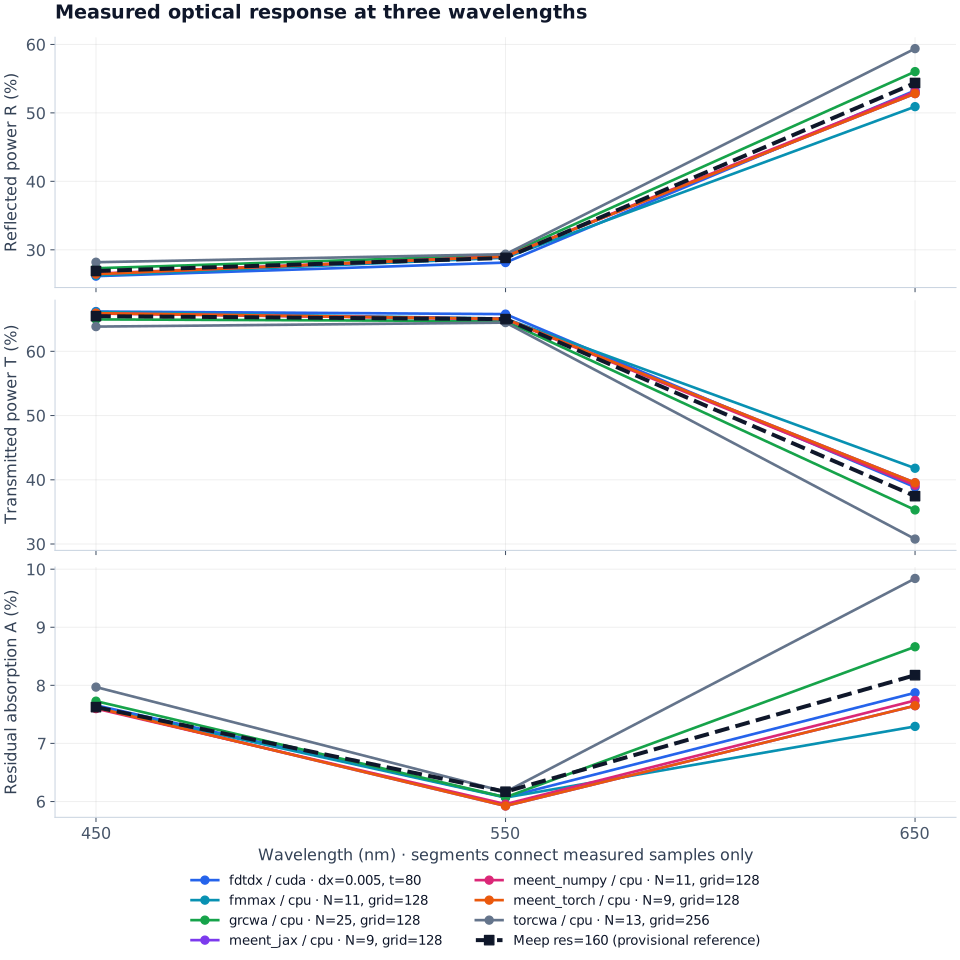
검은 점선은 Meep, 색 선은 각 솔버의 최고 측정 설정이다. 점 세 개만 실측이며 연결선은 중간 파장 예측이 아니다. 흡수 A는 1−R−T 잔차다. 범례에 사용한 차수·격자·장치를 함께 표시했다.
3. Meep 대비 차이
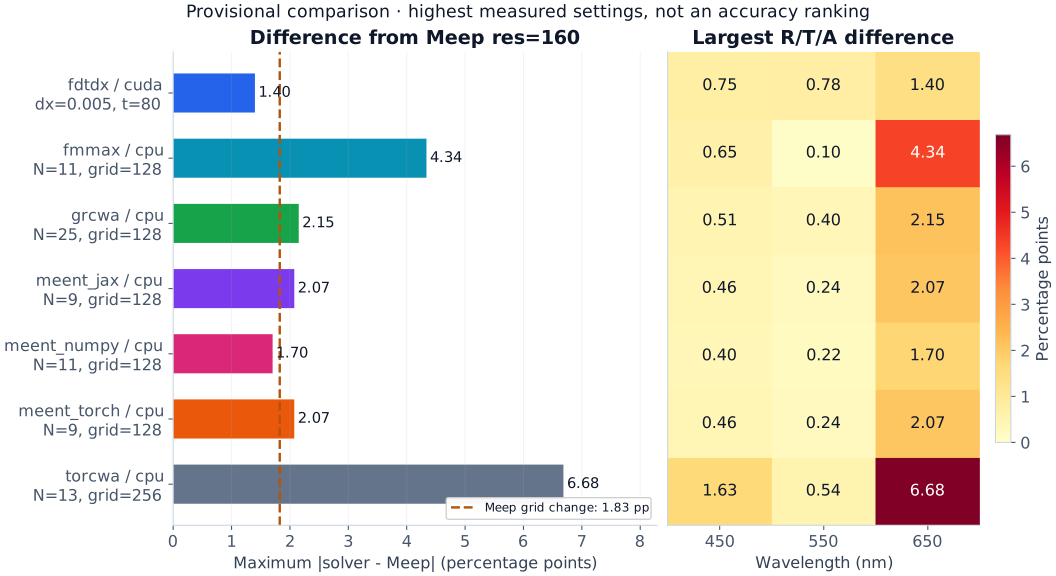
왼쪽은 세 파장 전체의 최대 차이, 오른쪽은 각 파장의 R/T/A 중 최대 차이다. 단위는 %p다. 주황 점선은 Meep 자체의 관측된 격자 변화다. 기준값 수렴이 미확정이므로 이 그림으로 정확도 순위를 확정하지 않는다.
4. CPU/GPU 실행시간과 가속률
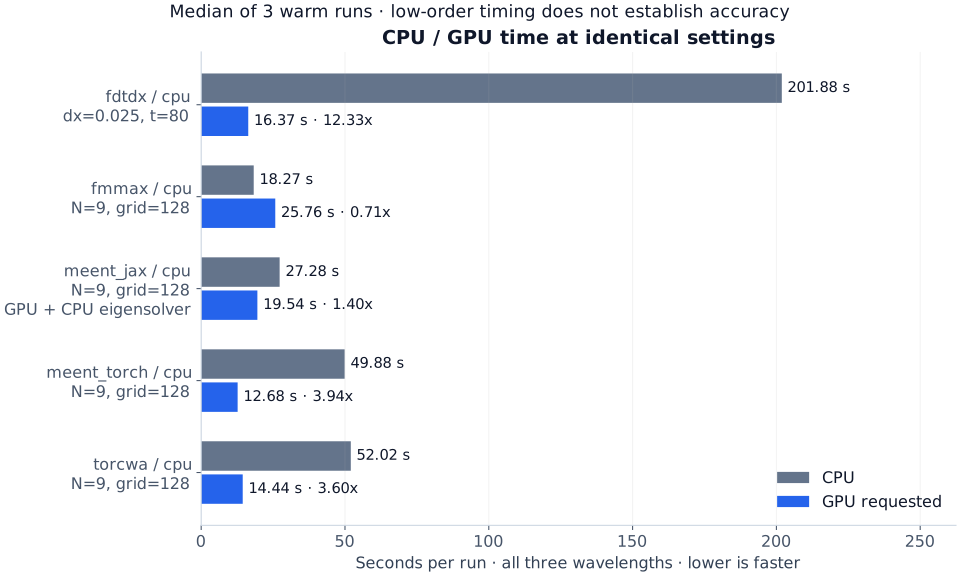
회색은 CPU, 파랑은 GPU 요청 경로이며 막대가 짧을수록 빠르다. 숫자는 세 파장 실행의 warm 3회 중앙값과 CPU/GPU 시간 비다. RCWA는 N=9 성능 조건이며 위 최고 차수 정확도 비교와 다른 실행이다. meent/JAX는 GPU 배열 계산과 CPU 고유값 풀이가 섞인 경로다.
검증 판정 수치표 펼치기
| 검증 항목 | 실측 / 판정 | 통과 기준 |
|---|---|---|
| 패턴 시간 수렴 (선택·이전 격자) | 0.000459519 / 통과 | 최대 ΔRTA ≤ 0.0005 |
| 패턴 공간 격자 수렴 | 0.0182532 / 기준 미충족 | 최대 ΔRTA ≤ 0.005 |
| PML 독립 검증 | 미측정; 미승인 | 최대 ΔRTA ≤ 0.001 및 양쪽 시간 수렴 |
| Meep 패턴 기준값 최종 승인 | 미확정 | 위 조건 모두 통과 |
ΔRTA는 세 파장의 R/T/A 중 최대 절대 차이다. 예를 들어 0.01825는 약 1.83%p이며 상대 오차 1.83%를 뜻하지 않는다. 박막의 TMM 검증은 아래에 별도로 제시하며 패턴의 격자·PML 수렴을 대신하지 않는다. 이번 비교에는 photodiode QE 검증이 포함되지 않는다.
Meep 격자·시간 검증 · CPU/GPU 성능 비교 · 파장별 R/T/A
환경과 측정 범위
- WSL2 Ubuntu 24.04, Python 3.12.3, CPU 12th Gen Intel(R) Core(TM) i5-12400F (논리 코어 12개).
- GPU: NVIDIA GeForce RTX 4060 Ti, NVIDIA-SMI 610.57.01 / Windows KMD 610.88, CUDA UMD 13.3. 드라이버 원문은 environment.json에 있다.
- PyTorch 2.15.0+cu132 (CUDA 13.2), JAX 0.12.0.1; 실제 CUDA 행렬 곱 결과를 양쪽에서 확인했다.
- Linux
.venv-wsl과 Linux 파일시스템의/home/edwin/.local/share/compass-miniconda/envs/meep을 사용한다. Windows.venv는 사용하지 않았다. Meep은 공식 conda-forge의 MPI PyMeep 1.35.0이다. - Meep 기준 계산은 CPU MPI 8개 프로세스를 쓴다. 다른 CPU 솔버의 1개 BLAS/PyTorch 스레드 시간과 코어 수를 같게 맞춘 성능 순위는 아니다. Meep 수렴 실행의 단일 wall time을 warm 3회 중앙값으로 표시하지 않는다.
- NumPy/BLAS/OMP/MKL 및 PyTorch 스레드 1개. JAX/XLA 내부 전체 스레드 수를 1개로 제한했다는 뜻은 아니다. 복소 RCWA 배정밀도, FDTDX 실수 필드 배정밀도 + 복소 DFT 배정밀도.
- 프로세스 시작, 공통 NumPy/PyTorch import, 장치 초기화와 소형 HLO probe는 시간에서 제외된다. cold는 완전히 새로운 OS 프로세스의 총 시작 시간이 아닌 어댑터 최초 run() 시간이다.
- 시간은 geometry/source 설정을 제외한
run()과 NumPy 결과 전송까지다. 최초 실행은 지연 import/JAX 컴파일을 포함하고, warm은 3회 중앙값이다. PyTorch CUDA는 전후 동기화하며 JAX는 결과의 호스트 변환으로 완료를 보장한다. - PyTorch 메모리는 max_memory_allocated/reserved, JAX는 device.memory_stats의 peak_bytes_in_use다. 드라이버 메모리와 전체 프로세스 VRAM의 같은 지표가 아니다.
- 수렴용 단일 실행과 반복 성능 측정을 구분한다. Meep 계산과 부하가 겹친 초기 시간은
pre_자료로 분리하거나 재측정한다.
공식 Meep 설치의 Conda 설치법과 복소 유전율/전도도 정의를 사용했다. PyPI의 다른 meep 패키지는 설치하지 않았다.
구조와 물리량
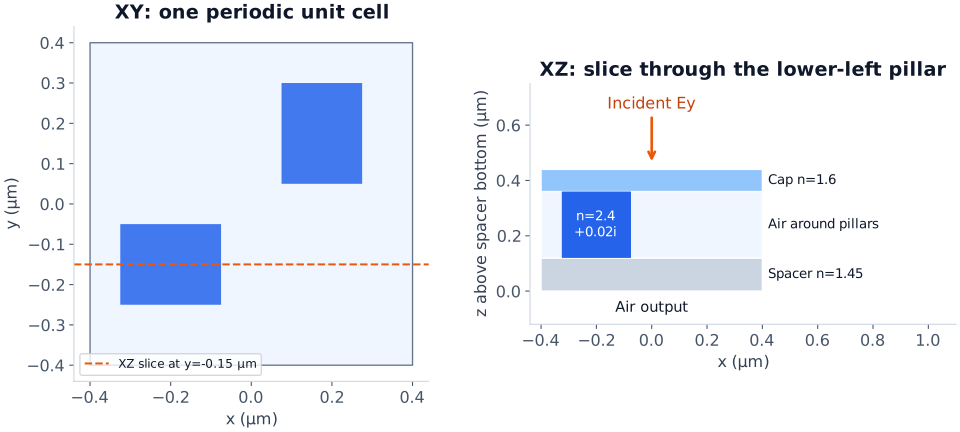
주기 0.8x0.8 µm, 공기 입출사, 수직 TE(Ey), 450/550/650 nm. 아래에서부터 n=1.45 spacer 0.12 µm, 높이 0.24 µm의 n=2.4+0.02i 기둥 2개, n=1.6 cap 0.08 µm이다. 기둥 (중심 x,y; 크기 x,y)은 (-0.2,-0.15;0.25,0.2), (0.175,0.175;0.2,0.25) µm이다. R/T는 모든 전파 회절차수의 총 파워다. A=1-R-T는 잔차이며 합계 1을 정확도 증거로 사용하지 않는다. 이번 경로에서 clipping을 제거했다. 합성 구조에는 photodiode가 없으며 QE 비교는 하지 않는다. torcwa/meent/fmmax는 사각형 기저 (2N+1)², grcwa는 원형 기저다. grcwa의 실제 모드 수를 기록하며 N 숫자만으로 동일 기저라고 간주하지 않는다. 격자 표의 요청값은 epsilon_grid 최소 크기다. 새 metadata에 실제 epsilon_grid_shape_yx가 있으면 주요 결과 표에 실제 x/y 크기를 표시한다. 독립 차수·격자 수렴의 그룹 기준은 요청값이며 이번 benchmark는 grid_multiplier=0을 사용한다.
Meep 박막 검증 (TMM 해석해)
공기/n=1.5+ik/공기, 두께 0.1 µm, k=0/0.005/0.05, 세 파장. 정상 입사 균일 박막은 1D Meep으로 독립 검증하고 COMPASS 3D 어댑터는 실제 통합 테스트로 검증한다. 각 재료는 목표 주파수에서 ε=(n+ik)²와 일치하도록 D_conductivity=2πf Im(ε)/Re(ε)를 사용한다.
| 해상도 (points/µm) | 9개 조건의 최대 R/T/A 오차 | 시간 40→80 최대 변화 |
|---|---|---|
| 80 | 0.00868404 | 5.855e-09 |
| 120 | 0.00547413 | 3.327e-09 |
| 160 | 0.0039906 | 1.197e-09 |
| 320 | 0.00191165 | 2.361e-08 |
| 640 | 0.000935403 | 3.584e-09 |
실제 GPU 및 FDTD 박막 검증
전체 실측 수치표 펼치기
| 솔버 / 장치 | k | 격자 간격 (µm) | 파장 수 | 최대 TMM R/T/A 오차 | 구현 상태 | 원시 파일 |
|---|---|---|---|---|---|---|
| fdtdx / cuda | 0.05 | 0.0125 | 3 | 0.0257605 | 이전 탐색 구현; 현행 검증에서 제외 | fdtdx_cuda_slab_absorbing_dx0125.json |
| fdtdx / cuda | 0.0 | 0.0125 | 3 | 0.00196442 | 현행 측정 | fdtdx_cuda_slab_dx0125_k0.0.json |
| fdtdx / cuda | 0.05 | 0.0125 | 3 | 0.00223926 | 현행 측정 | fdtdx_cuda_slab_dx0125_k0.05.json |
| fdtdx / cuda | 0.0 | 0.025 | 1 | 0.00135607 | 이전 탐색 구현; 현행 검증에서 제외 | fdtdx_cuda_slab_native.json |
| fdtd_flaport / cpu | 0.0 | 0.025 | 1 | 0.251581 | 현행 측정 | flaport_cpu_slab_after_device_fix.json |
| fdtd_flaport / cpu | 0.0 | 0.025 | 1 | 0.251581 | 현행 측정 | flaport_cpu_slab_final.json |
| fdtd_flaport / cuda | 0.0 | 0.025 | 1 | 0.251581 | 현행 측정 | flaport_cuda_slab_final.json |
| fmmax / cuda | 0.05 | N=1, eps=64 (요청) | 3 | 2.22045e-16 | 현행 측정 | fmmax_cuda_slab_absorbing.json |
| meent_jax / cuda | 0.05 | N=1, eps=64 (요청) | 3 | 3.33067e-16 | 현행 측정 | meent_jax_cuda_slab_absorbing.json |
| meent_torch_cfs / cpu | 0.05 | N=1, eps=64x64 (실제) | 1 | 2.77556e-17 | 현행 측정 | meent_torch_cfs_cpu_slab_api_smoke.json |
| meent_torch / cuda | 0.05 | N=1, eps=64 (요청) | 3 | 4.44089e-16 | 현행 측정 | meent_torch_cuda_slab_absorbing.json |
| torcwa / cuda | 0.05 | N=1, eps=64 (요청) | 3 | 7.42655e-11 | 현행 측정 | torcwa_cuda_slab_absorbing.json |
Meep 패턴 격자·시간 수렴
PML 밖 공기에 소스/면 모니터를 놓고 동일 셀의 빈 공간 계산에서 얻은 DFT 필드를 반사 모니터에서 뺀다. 입사 플럭스는 -z 방향의 음수, 반사 플럭스는 양수다. 전도도는 파장마다 다시 계산한다. 전체 셀 면적의 DFT 플럭스를 적분하므로 회절차수를 빠뜨리지 않는다. 펄스 폭과 air/PML 크기를 바꾼 탐색 계산은 원시 자료에 보존한다. 최종 격자 비교는 동일한 좁은 펄스와 air/PML 설정만 사용하며 PML 폭의 독립 수렴 시험으로 대체하지 않는다. 광펄스 종료 후 시간의 누적 DFT 결과를 저장하며, 격자 판정은 인접 최고 해상도 변화 ≤0.005, 시간 판정은 마지막 두 시간 변화 각각 ≤0.0005이다. PML 판정은 동일한 최고 격자·소스·시간 설정에서 인접 PML 폭 변화 ≤0.001이다. 기본 0.35→0.7 µm가 실패하면 더 넓은 인접 PML 쌍과 선택한 PML의 낮은 해상도를 추가 검증한 뒤 기준을 변경한다. 이전 PML의 결과를 새 설정의 수렴 증거로 대신하지 않는다. 이 변화 기준은 엄밀한 오차 상계가 아니다.
| 해상도 | post-source 시간 상한 | air / PML (µm) | 계산된 파장 수 | 상태 |
|---|---|---|---|---|
| 80 | 40.0 | 0.4 / 0.35 | 3 | ok |
| 80 | 40.0 | 0.8 / 0.5 | 3 | ok |
| 120 | 185.0 | 0.4 / 0.35 | 3 | ok |
| 160 | 185.0 | 0.4 / 0.35 | 3 | ok |
| 200 | 185.0 | 0.4 / 0.35 | 1 | stopped_by_scope |
주 기준 실행의 파장별 실제 종료시간과 마지막 두 누적 DFT 변화다. 시간 상한에 도달한 것과 시간 수렴 통과를 구분한다. 아직 계산하지 않은 파장을 0 또는 수렴한 값으로 채우지 않는다.
전체 실측 수치표 펼치기
| 원시 파일 / 해상도 | λ (nm) | 실제 post-source 종료 (µm/c) | 이전 구간 / ΔRTA | 마지막 구간 / ΔRTA | 시간 판정 |
|---|---|---|---|---|---|
meep_reference_r120.json / 120 | 450 | 145.0 | 80.0→110.0 / 0.000172827 | 110.0→145.0 / 3.49153e-05 | 통과 |
meep_reference_r120.json / 120 | 550 | 185.0 | 110.0→145.0 / 0.000459519 | 145.0→185.0 / 0.000233784 | 통과 |
meep_reference_r120.json / 120 | 650 | 145.0 | 80.0→110.0 / 3.99349e-05 | 110.0→145.0 / 4.51457e-06 | 통과 |
meep_reference_r160.json / 160 | 450 | 110.0 | 55.0→80.0 / 0.000318388 | 80.0→110.0 / 0.000114209 | 통과 |
meep_reference_r160.json / 160 | 550 | 185.0 | 110.0→145.0 / 0.00032783 | 145.0→185.0 / 0.000265842 | 통과 |
meep_reference_r160.json / 160 | 650 | 145.0 | 80.0→110.0 / 5.1117e-05 | 110.0→145.0 / 3.68335e-06 | 통과 |
meep_reference_r200.json / 200 | 450 | 80.0 | 35.0→55.0 / 0.000378006 | 55.0→80.0 / 0.000451409 | 통과 |
meep_reference_r200.json / 200 | 550 | 미측정 | 미측정 | 미측정 | 미측정 (측정 종료) |
meep_reference_r200.json / 200 | 650 | 미측정 | 미측정 | 미측정 | 미측정 (측정 종료) |
비교에 선택한 Meep 파일: meep_reference_r160.json; PML 0.35 µm. 짝을 이룬 낮은 해상도 파일: meep_reference_r120.json. 동일 PML의 인접 최고 격자 변화: 0.01825320151341342; 최고/이전 격자의 마지막 두 구간 최대 시간 변화: 0.00032783035137273764 / 0.0004595186575556687. 선택한 PML 변화: None; 해당 두 계산의 최대 시간 변화: None. PML 판정: stopped_by_scope / 선택 PML 허용 False. 수렴 판정: 미확정.
Meep PML 독립 검증
원래 PML 허용: False. 원시 자료에서 재계산한 선택 PML 검증의 마지막 두 구간 최대 시간 변화: None. 전체 기준값 승인은 두 격자와 PML 비교 양쪽 계산의 시간 변화가 모두 ≤0.0005일 때만 가능하다.
| PML 폭 변화 (µm) | 최대 ΔRTA |
|---|---|
| 미측정 (측정 종료) | — |
CPU/GPU 동일 조건의 성능과 결과 차이
전체 실측 수치표 펼치기
| 솔버 | N / 격자 | 실제 모드 | CPU cold / warm (s) | GPU cold / warm (s) | 가속률 | CPU↔GPU 최대 ΔRTA | Meep 최대 ΔRTA | GPU allocator peak (MiB) |
|---|---|---|---|---|---|---|---|---|
| fdtdx | 0 / 64 (요청) | None | 200.368 / 201.882 | 31.282 / 16.367 | 12.335x | 3.553e-15 | 0.137119676554073 | 81.8 |
| fmmax | 9 / 128 (요청) | 361 | 23.694 / 18.268 | 34.078 / 25.763 | 0.709x | 4.038e-11 | 0.056506430683840814 | 1105.5 |
| grcwa | 9 / 128 (요청) | 357 | 30.111 / 21.952 | 해당 없음 / 미측정 | — | — | 0.089347064517452 | — |
| meent_jax | 9 / 128 (요청) | 361 | 32.647 / 27.278 | 26.078 / 19.541 | 1.396x | 2.801e-13 | 0.020744622061702023 | 2557.0 |
| meent_numpy | 9 / 128 (요청) | 361 | 51.336 / 49.158 | 해당 없음 / 미측정 | — | — | 0.0207446220621067 | — |
| meent_torch | 9 / 128 (요청) | 361 | 59.585 / 49.879 | 18.512 / 12.675 | 3.935x | 1.793e-12 | 0.020744622058513573 | 1835.4 |
| torcwa | 9 / 128 (요청) | 361 | 52.626 / 52.025 | 15.756 / 14.444 | 3.602x | 7.672e-14 | 0.09849500557913782 | 1119.8 |
meent/JAX의 GPU 열은 GPU 배열 연산 + CPU 고유값 풀이의 혼합 경로다. 완전 GPU 실행의 가속률로 해석하지 않는다. 위 Meep 오차는 최고 측정 격자와의 차이다. Meep 기준값이 미확정이면 정확도 순위로 사용하지 않는다. 낮은 차수의 빠른 결과를 정확한 솔버로 추천하지 않는다.
고차수 CPU/GPU 결과 일치
반복 시간 측정과 별개로 동일 입력의 고차수 결과를 비교한다. 단일 수렴 실행에는 warm 가속률을 붙이지 않는다.
| 솔버 | N / 유전율 격자 | 실제 모드 | CPU↔GPU 최대 ΔRTA |
|---|---|---|---|
| torcwa | 13 / 128 (요청) | 729 | 1.915e-13 |
차수와 유전율 격자의 독립 수렴
전체 실측 수치표 펼치기
| 솔버 / 장치 | 격자 | N 변화 | 모드 수 변화 | 최대 ΔRTA |
|---|---|---|---|---|
| fmmax / cpu | 128 | 9→11 | 361→529 | 0.0131226 |
| grcwa / cpu | 128 | 9→11 | 357→529 | 0.0177556 |
| grcwa / cpu | 128 | 11→13 | 529→725 | 0.0129691 |
| grcwa / cpu | 128 | 13→17 | 725→1225 | 0.0167774 |
| grcwa / cpu | 128 | 17→21 | 1225→1837 | 0.0128368 |
| grcwa / cpu | 128 | 21→25 | 1837→2601 | 0.00750202 |
| meent_jax / cuda | 128 | 3→9 | 49→361 | 0.109891 |
| meent_numpy / cpu | 128 | 9→11 | 361→529 | 0.00371063 |
| torcwa / cpu | 128 | 9→11 | 361→529 | 0.0177467 |
| torcwa / cpu | 128 | 11→13 | 529→729 | 0.0153384 |
| torcwa / cuda | 128 | 9→13 | 361→729 | 0.0330851 |
| 솔버 / 장치 | N | 격자 변화 | 최대 ΔRTA |
|---|---|---|---|
| grcwa / cpu | 13 | 64→128 | 0.00703711 |
| grcwa / cpu | 13 | 128→256 | 0.00166374 |
| torcwa / cpu | 13 | 64→128 | 0.00600328 |
| torcwa / cpu | 13 | 128→256 | 0.00143405 |
meent CFS 별도 알고리즘 검증
meent_torch_cfs는 Torch backend의 fourier_type=1 (continuous Fourier series)이다. 기존 meent/torch의 fourier_type=0, enhanced_dfs=True (enhanced discrete Fourier series)와 별도 조건으로 기록한다. 기본 설정과 기존 측정은 유지했다. CFS는 작은 입력 격자에서 해석적으로 계수를 적분하므로 같은 격자의 DFS FFT Nyquist 제한을 그대로 적용하지 않는다. epsilon_grid_shape_yx는 어댑터가 전달한 실제 입력 격자다. DFS의 fourier_work_grid_shape_yx는 설치된 upstream 반복 규칙으로 유도한 FFT 작업 격자이며 별도의 runtime 배열 관측치나 GPU 메모리 측정값이 아니다. enhanced DFS는 N>0일 때 축별 입력을 (4N+2)배 반복한다. 예를 들어 N9/input128은 4864x4864, N29/input256은 30208x30208이며 후자의 complex128 배열 하나만 약 13.6 GiB다. 단일 배열 추정치와 allocator peak를 동일하게 해석하지 않는다. CFS는 이 FFT 작업 격자를 만들지 않으므로 해당 metadata는 null이다. CFS의 정확도 계산은 repeats=0으로 수집하며 기존 단독 N9 DFS의 warm 가속률을 CFS 또는 고차수로 외삽하지 않는다. GPU 잠금으로 직렬화하지만 CPU 정확도 작업과 겹칠 수 있다. 550 nm CPU 박막 API smoke는 패턴의 세 파장 검증과 별도 조건이다. 추가 CFS workflow 상태: stopped_by_scope; 박막·장치 gate: 미측정; 차수 수렴: 미측정; 입력 격자 수렴: 미측정. 이 상태만으로 Meep 대비 정확도 통과를 주장하지 않는다. DFS↔CFS 차이 0.005는 두 알고리즘의 동일 차수 결과를 진단하는 기준이다. 이를 초과하면 같은 정확도로 간주하지 않으며 CFS 자체의 차수·격자 수렴과 최종 Meep 오차를 따로 평가한다. 해석 박막 및 CPU/GPU 일치 검증이 실패하면 고차수 CFS 확장을 중단한다.
| CFS 검증 | 최대 ΔRTA | 기준 | 판정 | 근거 파일 |
|---|---|---|---|---|
| 대기 / 아직 측정되지 않음 | — | — | 미확정 | — |
별도 CPU CFS 550 nm 흡수 박막 smoke의 최대 TMM 오차: 2.7755575615628914e-17; meent_torch_cfs_cpu_slab_api_smoke.json. GPU 패턴 검증을 대신하지 않는다.
FDTDX 유전율 격자 수렴
동일한 실행시간끼리만 공간 격자를 비교한다. PML 셀 수는 물리적 폭을 일정하게 유지하도록 격자 간격에 반비례한다.
| 실행시간 (µm/c) | GPU 격자 간격 변화 (µm) | 최대 R/T/A 변화 | 최고 Meep 격자 대비 차이 |
|---|---|---|---|
| 80.0 | 0.025→0.0125 | 0.180307 | 0.04318689135626641 |
| 80.0 | 0.0125→0.01 | 0.0143595 | 0.04115674477813469 |
| 80.0 | 0.01→0.005 | 0.0271519 | 0.014004820062294032 |
FDTDX 실행시간 수렴
동일한 공간 격자와 PML 설정을 유지하고 총 실행시간을 늘린 독립 계산이다. Meep의 post-source 시간과 직접 같은 시간 정의로 간주하지 않는다.
| GPU 격자 간격 (µm) | 실행시간 변화 (µm/c) | 최대 ΔRTA |
|---|---|---|
| 0.01 | 40.0→80.0 | 0.0232781 |
| 0.01 | 80.0→160.0 | 0.00215508 |
실측 R/T/A (최고 측정 차수; 수렴 판정과 별개)
전체 실측 수치표 펼치기
| 솔버 | N / 격자 | λ (nm) | R | T | A |
|---|---|---|---|---|---|
| Meep | res=160 | 450 | 0.26900609 | 0.65474094 | 0.07625297 |
| Meep | res=160 | 550 | 0.28818684 | 0.65012910 | 0.06168405 |
| Meep | res=160 | 650 | 0.54368782 | 0.37456001 | 0.08175217 |
| fdtdx / cuda | dx=0.005, t=80.0 | 450 | 0.26153364 | 0.66190732 | 0.07655904 |
| fdtdx / cuda | dx=0.005, t=80.0 | 550 | 0.28135126 | 0.65791834 | 0.06073040 |
| fdtdx / cuda | dx=0.005, t=80.0 | 650 | 0.53271236 | 0.38856483 | 0.07872281 |
| fmmax / cpu | 11 / 128 (요청) | 450 | 0.26256156 | 0.66125415 | 0.07618429 |
| fmmax / cpu | 11 / 128 (요청) | 550 | 0.28845788 | 0.65085846 | 0.06068366 |
| fmmax / cpu | 11 / 128 (요청) | 650 | 0.50912518 | 0.41794386 | 0.07293096 |
| grcwa / cpu | 25 / 128 (요청) | 450 | 0.27304344 | 0.64968046 | 0.07727609 |
| grcwa / cpu | 25 / 128 (요청) | 550 | 0.29221881 | 0.64704629 | 0.06073490 |
| grcwa / cpu | 25 / 128 (요청) | 650 | 0.56030740 | 0.35305391 | 0.08663869 |
| meent_jax / cpu | 9 / 128 (요청) | 450 | 0.26453241 | 0.65931362 | 0.07615397 |
| meent_jax / cpu | 9 / 128 (요청) | 550 | 0.29027290 | 0.65049101 | 0.05923609 |
| meent_jax / cpu | 9 / 128 (요청) | 650 | 0.52819999 | 0.39530463 | 0.07649538 |
| meent_numpy / cpu | 11 / 128 (요청) | 450 | 0.26522344 | 0.65878696 | 0.07598960 |
| meent_numpy / cpu | 11 / 128 (요청) | 550 | 0.29038928 | 0.65006207 | 0.05954866 |
| meent_numpy / cpu | 11 / 128 (요청) | 650 | 0.53100829 | 0.39159400 | 0.07739771 |
| meent_torch / cpu | 9 / 128 (요청) | 450 | 0.26453241 | 0.65931362 | 0.07615397 |
| meent_torch / cpu | 9 / 128 (요청) | 550 | 0.29027290 | 0.65049101 | 0.05923609 |
| meent_torch / cpu | 9 / 128 (요청) | 650 | 0.52819999 | 0.39530463 | 0.07649538 |
| torcwa / cpu | 13 / 256 (요청) | 450 | 0.28184451 | 0.63845824 | 0.07969725 |
| torcwa / cpu | 13 / 256 (요청) | 550 | 0.29362277 | 0.64471321 | 0.06166402 |
| torcwa / cpu | 13 / 256 (요청) | 650 | 0.59388169 | 0.30771607 | 0.09840223 |
최고 측정 설정의 Meep 차이 (수렴 판정과 별개):
전체 실측 수치표 펼치기
| 솔버 / 장치 | 최대 ΔRTA (세 파장 전체) | 원시 파일 |
|---|---|---|
| fdtdx / cuda | 0.0140048 | fdtdx_cuda_pattern_dx0.005.json |
| fmmax / cpu | 0.0433839 | fmmax_cpu_n11_g128_convergence.json |
| grcwa / cpu | 0.0215061 | grcwa_cpu_n25_g128_convergence.json |
| meent_jax / cpu | 0.0207446 | meent_jax_cpu_n9_g128_timed.json |
| meent_numpy / cpu | 0.017034 | meent_numpy_cpu_n11_g128_convergence.json |
| meent_torch / cpu | 0.0207446 | meent_torch_cpu_n9_g128.json |
| torcwa / cpu | 0.0668439 | torcwa_cpu_n13_g256_convergence.json |
fdtdz 별도 무손실 native 검증
재료 손실과 주기적 x/y 경계 API가 없는 CUDA 커널이다. 원래 패턴과 혼합하지 않고 n=1.5, 두께 0.1 µm 무손실 박막의 정상 입사 조건을 사용한다. 넓은 균일 소스의 중심에서 측면 경계 신호가 도달하기 전의 펄스를 DFT하고, 공기 중 reference-subtracted Ey 진폭으로 R/T를 구한다. 횡방향 폭과 시간 창을 변화시켜 1D 평면파 조건을 확인한다. z PML은 8셀 고정이므로 dx 감소 시 물리적 PML 폭도 0.2→0.1 µm로 바뀐다. 마지막 두 조건은 격자와 PML이 함께 변한 검증이며 독립적인 공간 격자 수렴으로 부르지 않는다. 이 추출기는 패턴의 모든 회절 파워를 구하는 용도가 아니다. 설치 상태: ok; 수치 실행 상태: ok. JAX 0.4.34/CUDA 12.6 전용 환경을 사용하며 32-bit, z 길이 제한 및 수동 launch_params를 명시했다. CPU lowering 지원 여부도 별도 시도한다. 원래 2D 주기 패턴의 CPU/GPU 가속률 표에 넣지 않는다. fdtdz_environment.json의 설치 성공 시각보다 오래된 native 결과는 이전 환경의 이력으로만 남기며 현 환경의 수치 실행 판정으로 쓰지 않는다. 아래 native 시간은 GPU 잠금으로 직렬화한 정확도 단계의 측정이며 CPU 정확도 계산과는 겹칠 수 있다. 단독 부하의 N9 성능 표와 같은 격리 조건으로 간주하지 않는다.
물리 정확도 판정: failed_physical_accuracy (승인 False). 커널 실행 status=ok는 정확도 승인이 아니다. 원래 손실성 주기 패턴의 속도 순위에서는 native 결과를 항상 제외한다. 물리 검증을 통과하지 않은 기준선은 별도 박막의 속도 추천에서도 제외한다. 모든 측정 조건의 최대 TMM 오차: 0.23064717358040077; 최종 선택 조건의 TMM 오차: 0.23064717358040077. 선택 조건 TMM 오차와 아래 수렴 변화가 각각 ≤0.005이고 입력·장치·반복 조건도 확인될 때만 별도 무손실 박막 범위에서 승인한다. 실패한 raw 값과 음수 A도 숨기거나 자르지 않는다.
| dx (µm) | x/y 셀 | 시간 창 (µm/c) | native cold / warm (s) | 최대 TMM ΔRTA | 이전 조건 대비 최대 변화 |
|---|---|---|---|---|---|
| 0.025 | 384 | 3.0 | 5.7358 / 4.1739 | 0.117729 | None |
| 0.025 | 384 | 3.5 | 4.4094 / 4.3301 | 0.148305 | 0.03374249743706281 |
| 0.025 | 512 | 3.5 | 9.7138 / 9.2358 | 0.148305 | 0.0 |
| 0.0125 | 768 | 3.5 | 33.0921 / 32.4099 | 0.230647 | 0.19382355844000132 |
독립 변화 비교는 같은 dx/횡폭의 시간 창, 같은 dx/시간의 횡폭, 같은 물리적 횡폭/시간의 격자+zPML 쌍을 구분한다. 최종 조건의 시간 쌍이 없으면 시간 수렴을 승인하지 않는다. 횡폭 검증이 낮은 해상도에만 있으면 그 범위를 아래 case 번호로 드러낸다. 격자+zPML 비교는 순수 격자 수렴으로 부르지 않는다.
| 변화 종류 | case 번호 (0부터) | 최대 ΔRTA |
|---|---|---|
| time | 0→1 | 0.0337425 |
| transverse_width | 1→2 | 0 |
| grid_and_z_pml | 1→3 | 0.193824 |
입력/실제 GPU 조건 확인: True; 반복 시간 조건 확인: True; 수렴 변화 확인: False.
실제 장치: cuda:0; CPU 실행 판정: unsupported. 이 커널의 별도 workspace는 JAX allocator 통계에 포함되지 않아 프로세스 VRAM peak로 보고하지 않는다.
실제 장치, 실패와 제한
- torcwa/meent/torch: 실제 torch.linalg.eig 입력 장치를 기록한다. torcwa upstream은 autograd용 고유벡터를 CPU에도 보관하므로 GPU→CPU 전송이 완전히 없는 구현은 아니다.
- fmmax: JAX 장치를 명시하고 실제 eig 호출과 HLO lowering을 기록한다. 설치된 JAX의
cusolver_geev_ffi는 GPU 고유값 계산이다. 옛 JAX에서의 host LAPACK 경로와 혼동하지 않는다. - meent/JAX: 요청 장치를 전달해 GPU 배열 계산은 수행하지만 upstream
primitives.eig가 CPU에 JIT한 함수를 pure_callback으로 호출한다. CPU/GPU 혼합 계산이며 완전 GPU 솔버로 세지 않는다. - grcwa 및 meent/numpy: CPU 전용. CUDA 요청을 지원하는 것처럼 보고하지 않는다.
- flaport: damping과 유전율 텐서를 필드 장치에 배치하고 전체 필드의 매 스텝 CPU 복사를 제거했다. 하지만 하드 소스/플럭스 정규화의 정확도 문제는 남아 있다. 실제 무손실 박막의 비물리 결과 때문에 정확한 패턴 속도 비교에서는 제외한다.
- fdtdz 1.1.3: 최초 빌드는 nvcc 부재로 실패했으나 별도 CUDA 12.6 컴파일러/JAX 0.4.34 환경에서 재설치했다. 설치와 수치 실행은 구분하며 아래 native 검증 결과를 따로 기록한다. 기존 COMPASS simulate API 및 주기적 x/y 경계/재료 손실과 호환되지 않으므로 원래 손실성 패턴의 정상 어댑터로 세지 않는다.
- FDTDX 0.6.3: 기존 simulate API 실패를 실제 재현한 뒤 place_objects/run_fdtd와 PhasorPoyntingFluxDetector로 구현했다. 손실은 sigma=omegaeps0eps''에 내부 격자 길이 단위 변환을 적용한다. 기준 빈 셀의 복소 DFT 필드를 빼고 플럭스를 정규화한다. 패턴 검증과 격자/시간 수렴 결과에 따라 사용 범위를 판정한다. QE는 미지원으로 NaN을 반환한다.
각 상태는 원시 JSON의 status다. 미완료·실패에는 대체 수치를 넣지 않고 정상 성능/정확도 표에서 제외한다. 이후 수정으로 해결된 이전 실패도 재현 기록으로 남긴다.
| 실제 실패/진단 파일 | 원시 상태 | 사유 |
|---|---|---|
| fdtdx_cuda_pattern_dx0.005_t160.json | stopped_by_scope | User requested a reasonable closeout; additional convergence runs stopped without substituting measurements. |
| fdtdx_cuda_slab_api.json | failed | RuntimeError: Invalid result: {'solver_name': 'fdtdx', 'qe_method': 'field_integration', 'grid_spacing': 0.025, 'pml_layers': 12, 'time_steps': 2000, 'courant_factor': 0.5, 'grid_size': (33, 33, 29), 'device': 'cuda', 'failed_runs': [{'wave |
| grcwa_cpu_n25_g256_convergence.json | stopped_by_scope | User requested a reasonable closeout; additional convergence runs stopped without substituting measurements. |
| meep_cw_pattern_diagnostic.json | timeout | 3D pattern CW trial interrupted after approximately 30 minutes without a converged result; not used as reference |
| torcwa_cpu_n17_g128_convergence.json | timeout | Process failure or timeout; see corresponding log |
측정 종료 기록
사용자의 추가 확장 중단 요청에 따라 측정을 종료했다. 완료된 실측은 보존하고 실행 중이던 추가 계산은 stopped_by_scope로 기록했다. 대기·중단 데이터는 측정값으로 대체하지 않았다. Meep 기준 수렴 판정은 미확정이며, 인접 최고 완료 격자의 최대 변화는 0.01825320151341342이다. 수렴 미확정 상태의 Meep 대비 차이는 잠정 비교로만 해석한다. N=9 가속률만으로 정확한 솔버를 추천하지 않는다. 추가 계산 프로세스는 모두 종료했다.
구현·검증과 재현
기존 비대칭 패턴의 torcwa/grcwa 입력 전치는 유지했다. torcwa field_xy의 [x,y] 출력을 QE의 [y,x] 격자로 돌려놓고 photodiode가 없으면 QE 재구성을 생략한다. meent에는 Torch/JAX 장치를 전달한다. RCWA의 유전율 격자는 epsilon_grid로 독립 제어하며 grid_multiplier=0이면 자동 oversampling을 끈다. meent/fmmax도 이 설정을 따르도록 수정했고 기본 grid_multiplier=3은 유지한다. 새 metadata의 epsilon_grid_requested는 요청 최소 크기, epsilon_grid_shape_yx는 실제 [y,x] 샘플 수다. 수정 직전 완료된 WSL meent/fmmax 결과 18개는 기존 max(epsilon_grid,3*(2N+1)) 식으로 확인했으며 모두 요청 격자와 같았다. 이 검토는 과거 runtime metadata를 새로 측정한 것처럼 채운 것이 아니다. 잔차 흡수를 자르지 않는다. Meep은 air padding, 고정 post-source 종료시간, 약한 손실 보존, 금속의 단일 주파수 Drude 매핑, DFT 필드 수명과 입사 파워 기준 흡수 적분을 수정했다. 전체 영역 박막 회귀 검증을 포함하지만 비대칭 개별 PD의 QE 동등성 검증은 이번 R/T/A 비교 범위 밖이다.
.venv-wsl/bin/python scripts/benchmark_wsl_solvers.py --environment
.venv-wsl/bin/python scripts/benchmark_wsl_solvers.py --jobs docs/public/reports/patterned-cpu-gpu-meep-wsl/timing_jobs.json
위 반복 성능 측정은 다른 계산이 없는 상태에서 먼저 끝낸다. 아래는 정확도·수렴 workflow다. 각 driver를 하나씩만 실행하고 기존 실행이 끝나기 전에 중복 시작하지 않는다. 완료 marker를 기다리는 driver와 GPU 파일 잠금이 의존 순서 및 GPU 동시 실행을 조절한다. 이 명령은 재현 절차이며 명령을 기재한 사실을 완료 증거로 사용하지 않는다. 각 실제 완료·실패는 위 표와 원시 JSON에 따른다.
전용 fdtdz 환경의 설치·검증 marker도 필요하므로 Linux conda 환경을 위 경로에 준비한 뒤 installer를 먼저 실행한다. 의존 버전은 첨부한 pip/conda 고정 목록에 기록했다.
.venv-wsl/bin/python scripts/install_fdtdz_legacy.py > outputs/patterned_cpu_gpu/wsl/fdtdz_installer_retry.log 2>&1
mkdir -p .cache
touch outputs/patterned_cpu_gpu/wsl/finish.log
.venv-wsl/bin/python scripts/finish_wsl_benchmarks.py > outputs/patterned_cpu_gpu/wsl/finish.log 2>&1 &
.venv-wsl/bin/python scripts/check_meep_pml_convergence.py > outputs/patterned_cpu_gpu/wsl/meep_pml.log 2>&1 &
.venv-wsl/bin/python scripts/run_fdtdz_validation.py > outputs/patterned_cpu_gpu/wsl/fdtdz_validation_driver_retry.log 2>&1 &
.venv-wsl/bin/python scripts/benchmark_high_order_gpu.py > outputs/patterned_cpu_gpu/wsl/high_gpu.log 2>&1 &
.venv-wsl/bin/python scripts/check_fdtdx_time_convergence.py > outputs/patterned_cpu_gpu/wsl/fdtdx_time.log 2>&1 &
.venv-wsl/bin/python scripts/benchmark_meent_cfs.py > outputs/patterned_cpu_gpu/wsl/meent_cfs.log 2>&1 &
wait
.venv-wsl/bin/python scripts/report_wsl_solvers.py
Meep 재현: python scripts/finish_wsl_benchmarks.py가 conda 환경의 mpirun -np 8 python scripts/benchmark_meep_reference.py를 호출한다. 고해상도에서는 좁은 광펄스와 비등간격 시간 체크포인트를 사용하고 마지막 두 구간의 R/T/A 변화가 각각 0.0005 이하일 때 조기 종료한다. 원시 JSON에 해상도, padding/PML, 펄스 폭, 실제 시간, signed flux, MPI 수를 기록했다. 수렴용 JSON에는 warm 반복 시간을 주장하지 않는다.